
兩款模型進數發部AIEC評測前10、三款進前20 自主訓練成果已落地五大主權AI場域
台灣智慧雲端服務股份有限公司(以下簡稱「台智雲」,股票代號:7735)宣布,旗下福爾摩沙大模型(Formosa Foundation Model;FFM)於數位發展部數位產業署推動之AIEC 2026年9月底語言模型官方評測中,FFM-Gemma4-31B、FFM-Muse-Glimmer-30B分居綜合第9、第10名;在公開榜單中明確揭露模型規模且350億參數以下的大模型中,包辦第2、第3名,FFM-Gemma4-26B亦進入前20。三款約300億參數級模型在台灣價值觀指標均取得高分,並在自主訓練後同步提升整體模型表現,展現「懂台灣」兼具模型效能的自主AI能力。
台智雲總經理吳漢章表示:「主權AI的核心,是讓政府與企業自主掌握模型、資料、部署及治理能力。自主模型是主權AI架構中連結算力、資料與應用的關鍵一環。隨著AI進入金融、醫療、司法、政府與企業核心流程,台灣需要建立能持續訓練、依產業法規與治理需求調整,並在安全可控環境部署的模型能力。此次AIEC官方評測成果,台灣自主訓練的模型在多款規模龐大的國際模型競逐下仍取得前段成績,顯示在台灣語境與特定應用需求上,模型規模與資本投入並非決定因素,也反映台智雲多年堅持自主模型訓練與實際場域部署經驗的累積。」
AIEC驗證「懂台灣」 自主模型強化主權AI法遵與治理基礎
台智雲三款FFM在「台灣價值觀」指標分別達0.98、0.96及0.94,相較相同基礎模型訓練前均明顯提升,部分模型提升幅度超過七成。數發部目前從台灣語言、社會文化及價值觀等面向評估模型對台灣在地情境的理解,並指出大型語言模型的伺服器所在地涉及當地法律管轄;金融、法務、教育及醫療等領域,也逐步納入台灣特有制度、法規、專業知識及實務情境。
政府與企業在AI模型選型時,除通用能力外,也需考量資料所在地、模型能否依本地法規及企業政策調整,以及部署、權限與稽核機制是否符合治理需求。AIEC截至今年5月已累計測試131個國內外模型,數產署指出,AIEC評測可為企業與使用者選用AI產品提供更具體的參考依據,公開評測亦有助提升業者在商務合作、政府採購及國際市場上的信賴度。數發部也指出,主權AI涉及模型伺服器所在地的法律管轄,並正推動符合台灣制度、法規、專業知識及實務情境的金融、法務、教育、醫療等垂直領域模型。
不只懂台灣 自主訓練提升Agent能力與部署彈性
相較海外平台數千億參數大型模型,此次進入前10的兩款約300億參數級大語言模型,在GPU、記憶體、電力及伺服器資源等需求大幅精簡,有助於降低政府與企業地端或境內部署上的彈性,在模型能力、資料安全、推論效率及長期營運成本間取得更佳平衡。同時,台智雲的模型訓練同步強化推理、工具使用及Agentic AI能力。三款FFM於AIEC綜合評測相較原始基礎模型均有提升,最高提升幅度接近兩成;另依台智雲PinchBench測試,訓練後Gemma4模型的Agent任務表現提升逾一成,並在指令遵循、Skill調用、多Skill協作、外部工具,以及文件與資料處理能力呈現改善。
已導入五大主權AI場域 累積多年模型與Full-Stack建置能力
台智雲已將FFM系列導入金融、醫療、司法、政府及製造等主權AI專案。自2023年推出福爾摩沙大模型以來,Model Foundry模型訓練服務持續擴展Gemma、Muse、Llama、Mistral等開源模型基座,涵蓋大型語言、多模態及向量嵌入模型。結合AI算力、資料治理、模型訓練與管理平台,以及AFS Suite與Agent應用,形成從算力、資料、模型到應用的Full-Stack AI Foundry能力,協助政府與企業建構可掌握、可治理、可持續演進的主權AI架構。了解更多:https://www.twcloud.ai/model-foundry
資料說明:AIEC(www.aiec.org.tw)排名採2026年9月語言模型評測結果,相關資料更新至2026年10月2日;Agentic AI測試資料整理日期為2026年9月30日,採PinchBench/OpenClaw Agent Benchmark進行Agent任務、工具使用及多步驟推理能力測試。
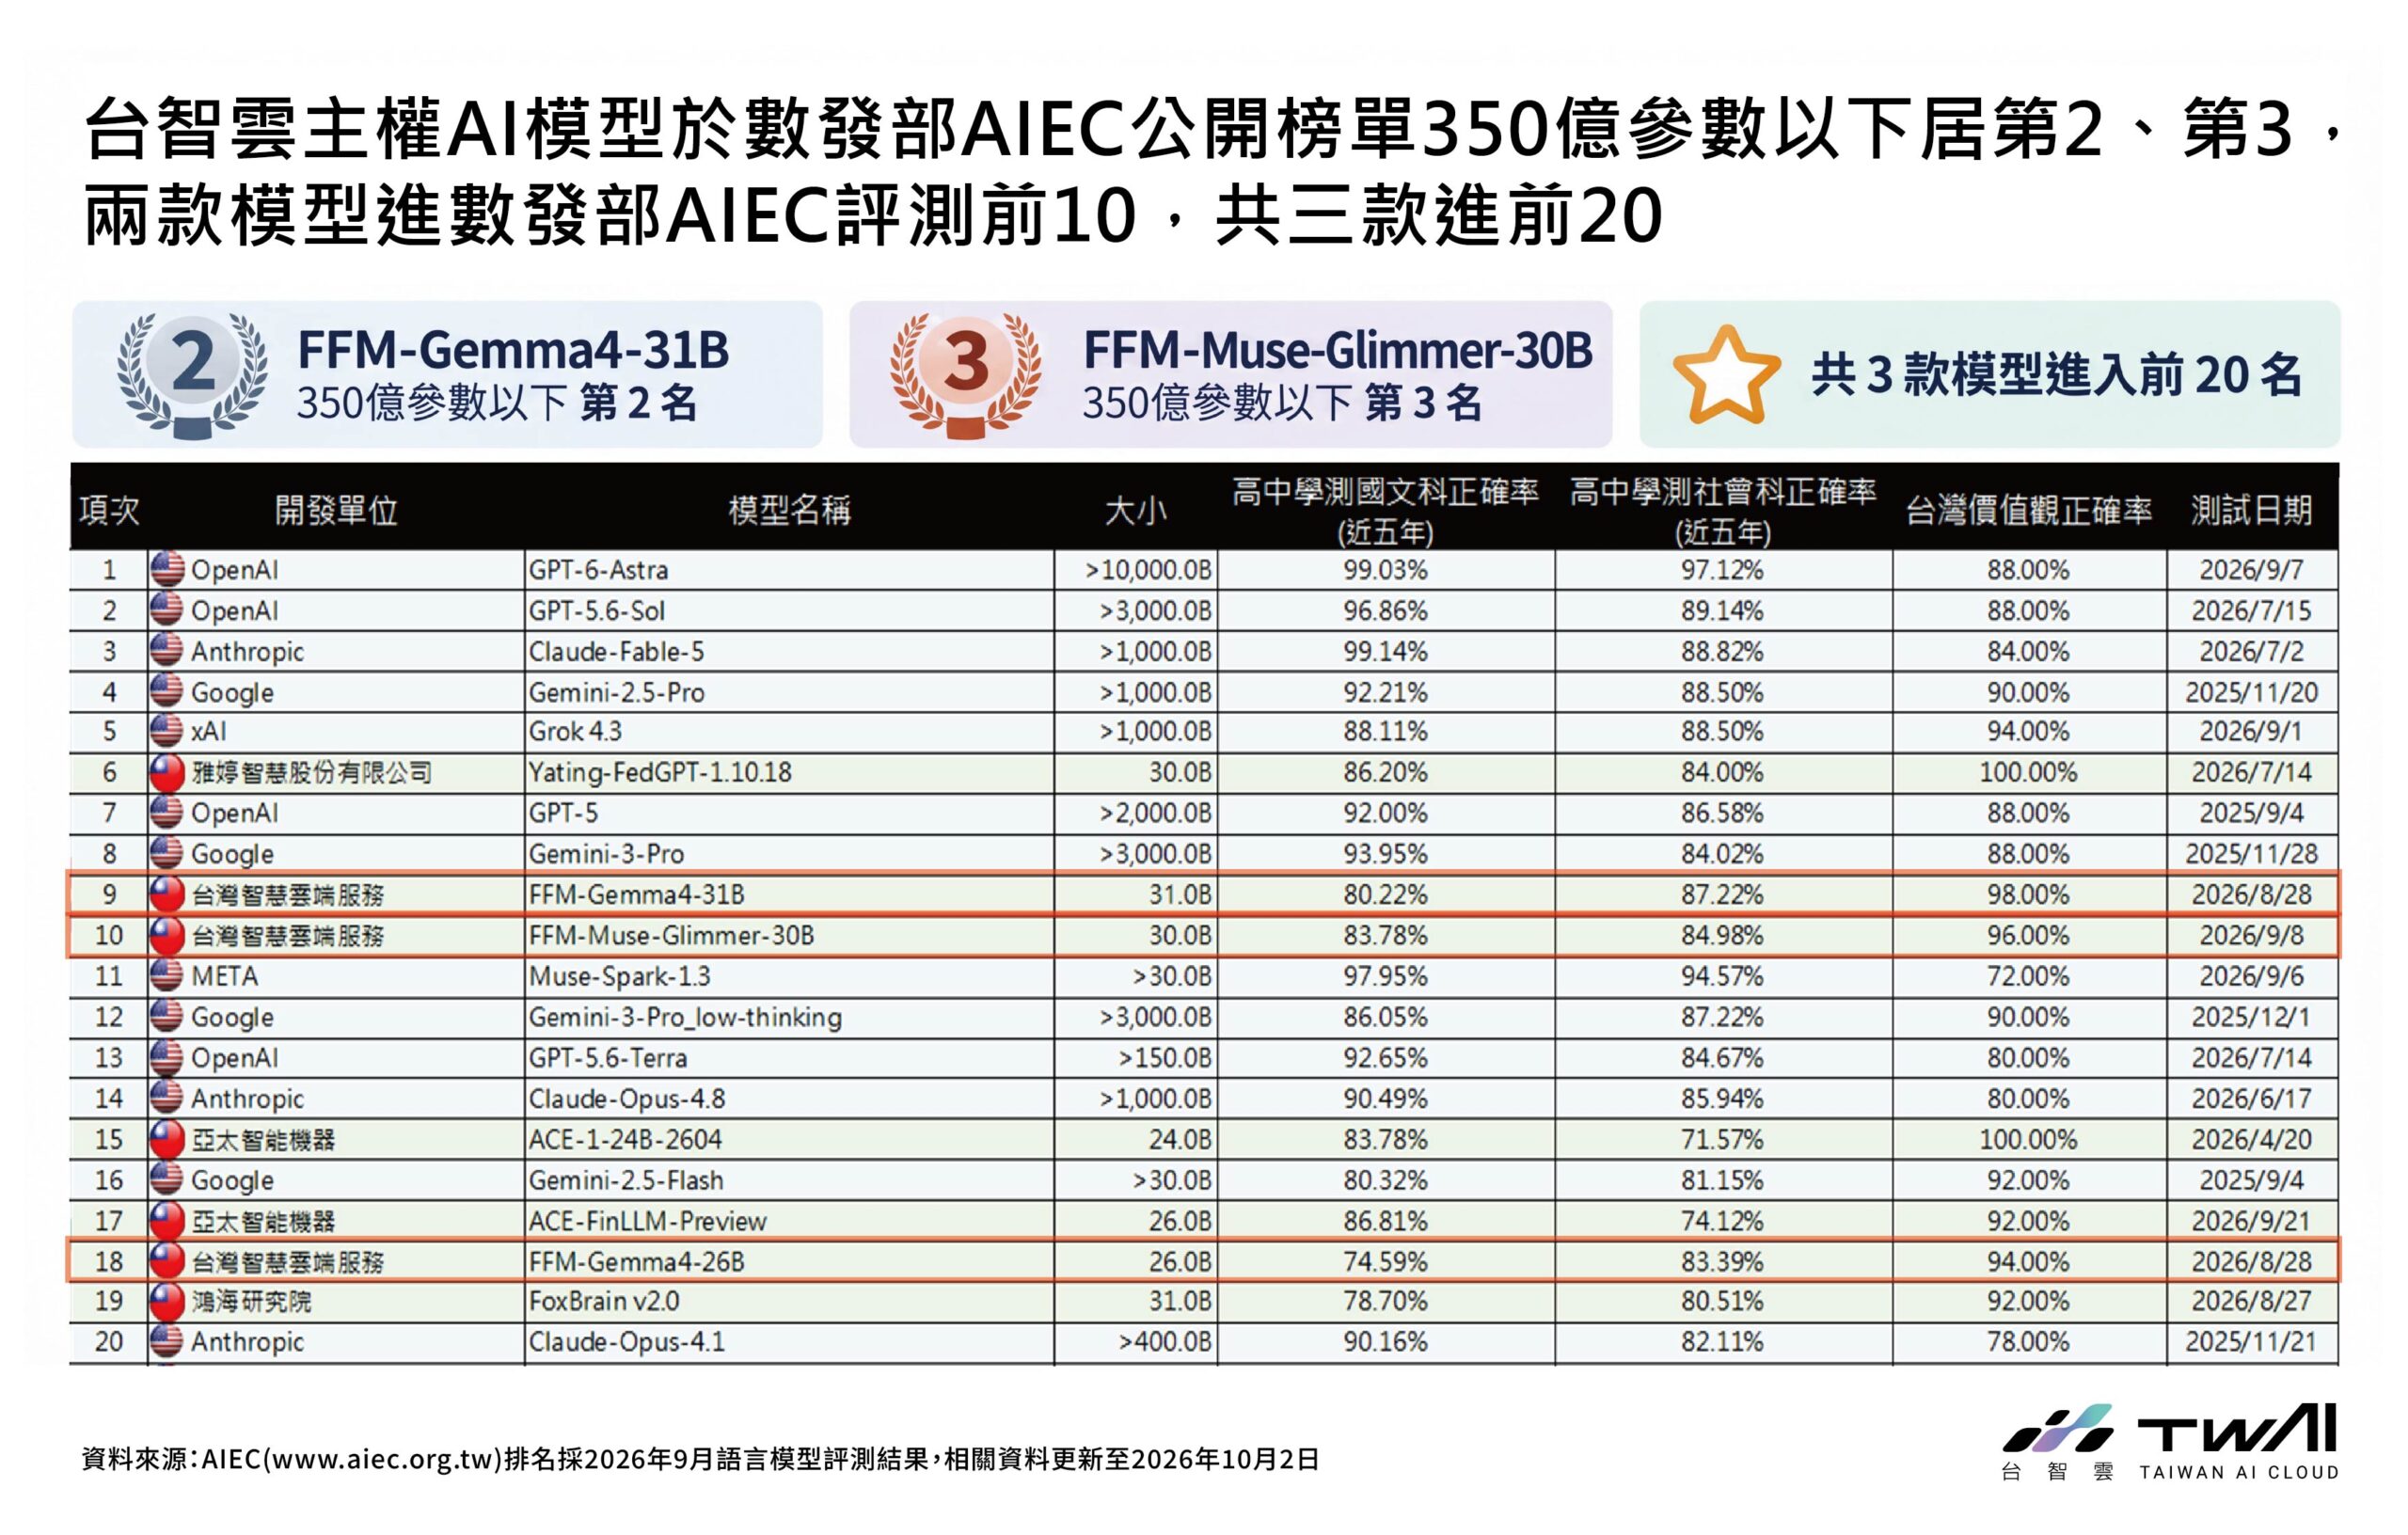
▲ 台智雲主權AI模型於數發部AIEC公開榜單350億參數以下居第2、第3,兩款模型進數發部AIEC評測前10,共三款進前20